~2~Проблема ~p~Международная компания накопила большой архив отсканированных договоров, накладных, спецификаций и операционных документов. Команда создала MVP, объединив распознавание текста, семантический поиск и языковую модель, чтобы сотрудники могли задавать вопросы по всему архиву, не открывая файлы по одному. ~2~Задача ~p~В архиве были старые сканы, перевёрнутые страницы, непоследовательные метаданные и изображения низкого качества. Обычный поиск по именам файлов не помогал находить ответ, распределённый между несколькими договорами или дополнительными соглашениями. Сотрудникам приходилось искать документы, вручную их сравнивать и готовить сводку — нередко в короткие сроки для внутренних проверок или регуляторов. ~p~Заказчику был нужен не только ответ, но и возможность точно проверить, какие первичные документы его подтверждают.
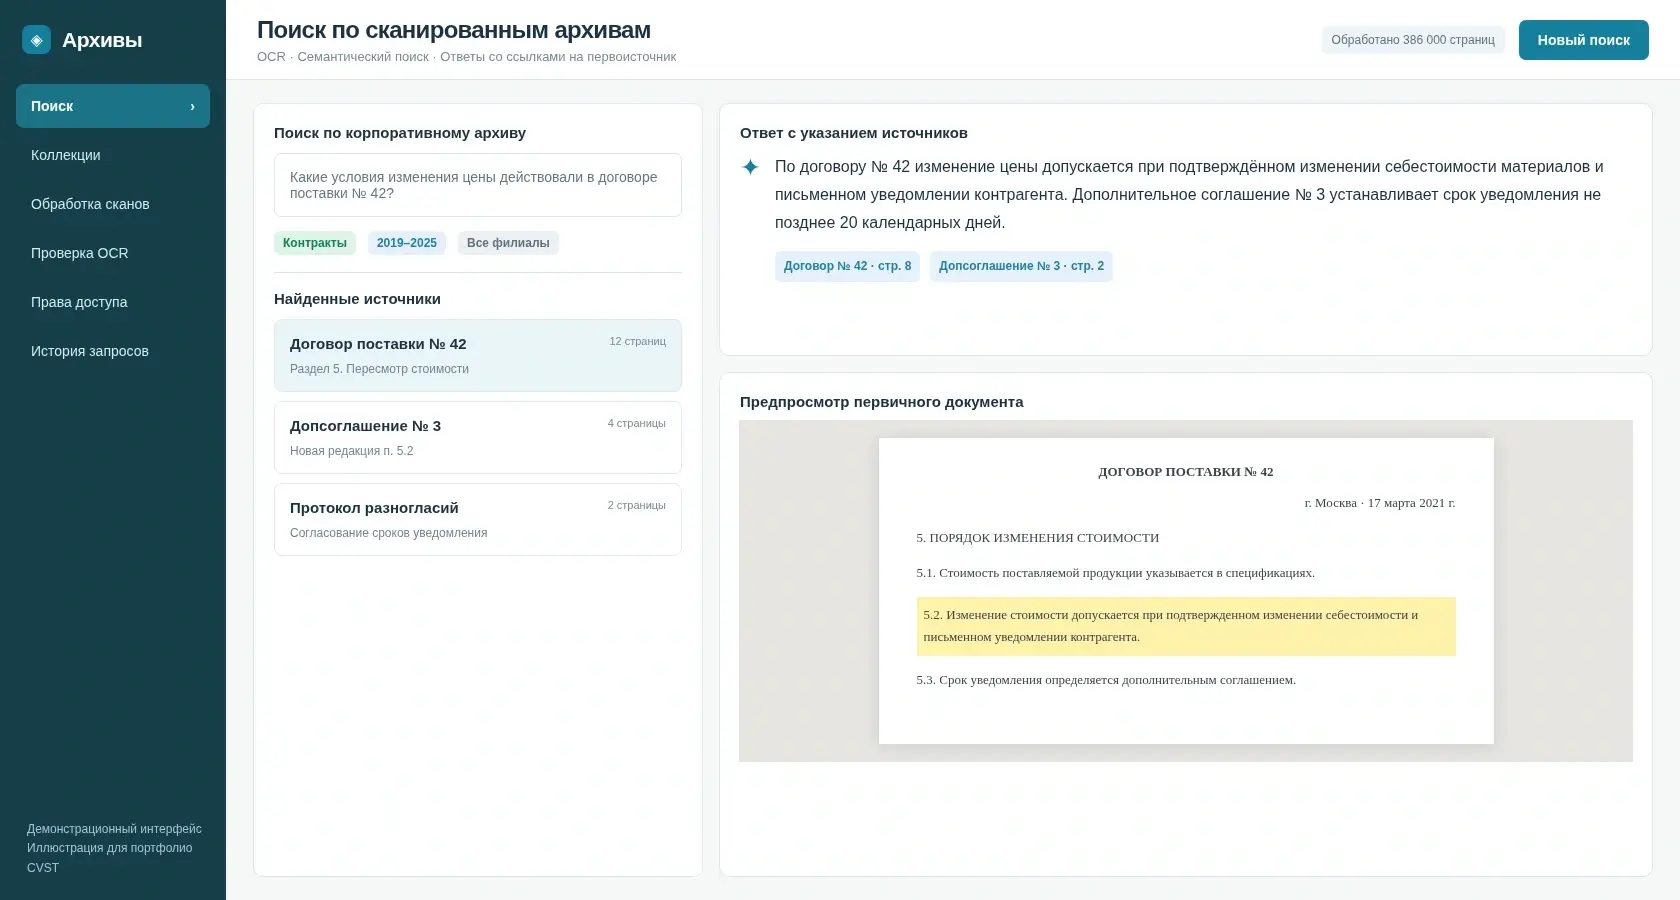
~2~Решение ~3~OCR для неоднородных архивов ~p~Система преобразует сканированные страницы в машиночитаемый текст. Она учитывает различия в качестве сканов и использует дополнительный мультимодальный компонент для извлечения данных в сложных случаях. ~3~Структурирование текста и семантический поиск ~p~Распознанный контент делится на смысловые фрагменты и индексируется для поиска. Векторный поиск определяет релевантные разделы по смыслу, а не только по именам файлов или точным ключевым словам. ~3~Вопросы по нескольким документам с источниками ~p~Языковая модель объединяет релевантные фрагменты и составляет ответ на естественном языке. Интерфейс связывает выводы с документами и конкретными цитируемыми фрагментами, позволяя проверить доказательства и разобраться в расхождениях. Это особенно полезно при совместном анализе договоров и дополнительных соглашений. ~2~Технические особенности ~p~Сначала OCR обрабатывает неоднородные изображения, в том числе перевёрнутые и зашумлённые сканы. Мультимодальная модель помогает восстановить сведения со сложных страниц. Затем распознанный текст разбивается на смысловые фрагменты и индексируется для векторного поиска. Генерация с извлечением контекста (RAG) объединяет выдержки из нескольких документов при подготовке ответа. ~p~Возможность проверки источников была ключевым требованием. Если сотрудник спрашивает, как менялись условия договора в течение нескольких лет, ассистент сопоставляет исходный договор, последующие соглашения и связанные записи. Каждый вывод сопровождается ссылкой на документ и нужный фрагмент, что позволяет использовать ответ при аудите, закупках и подготовке информации для регуляторов. ~3~Связь ответа с документами архива ~p~RAG-модуль сопоставляет фрагменты из разных файлов и составляет ответ со ссылками на конкретные источники. Первый рабочий прототип был подготовлен для проверки качества поиска на документах организации.
~2~Результат
~p~MVP показал, что поиск, ранее занимавший часы, может выполняться за минуты. На испытаниях MVP извлечение информации происходило в 10–30 раз быстрее ручного поиска по архиву. Система продемонстрировала точность более 90% на типовых вопросах и возвращала ссылки на источники вместе с ответами.
~p~Результат не ограничивается распознаванием: сотрудники могут сопоставлять сведения между договорами и изменениями к ним, прослеживая каждый вывод до подтверждающих записей.
Хотите реализовать похожий проект? Расскажите о своей задаче, и мы обсудим возможное решение